Java開発者のためのBigDecimal入門
BigDecimalは、Javaで非常に精度の高い数値計算を行うためのクラスです。
特に、金融アプリケーションや科学計算など、浮動小数点数の誤差が許容できない場合に使用されます。
今回はBigDecimalの紹介をしていきます。
なぜBigDecimalが必要なのか?
Javaで小数を扱うデータ型は以下です。
- float
- double
- BigDecimal
ただ、float、doubleに関しては浮動小数点数の誤差が発生するため、正確に計算を行うことができません。
public class FloatingPointError {
    public static void main(String[] args) {
        double sum = 0.0;
        for (int i = 0; i < 10; i++) {
            sum += 0.1;
        }
        System.out.println("Expected: 1.0");
        System.out.println("Actual: " + sum);
    }
}
このコードでは、0.1を10回加算して1.0を期待しますが、実際には浮動小数点の誤差のために、1.0とはわずかに異なる値が出力されます。
そのため、小数を含む計算で誤差を避けるためにはBigDecimalで計算を行う必要があります。
BigDecimalの生成方法
BigDecimalには生成するためのコンストラクタが準備されております。
import java.math.BigDecimal;

public class BigDecimalExample {
    public static void main(String[] args) {
        BigDecimal num1 = new BigDecimal("123.45"); // 文字列から生成
        BigDecimal num2 = new BigDecimal(123.45);   // doubleから生成(推奨されない)
        BigDecimal num3 = new BigDecimal(123);      // intから生成
    }
}
対応するデータ型は以下です。
- 文字列 (String)
- 浮動小数点型 (float, double):精度の問題があるため、非推奨だが使用可能
- 整数型 (byte, short, int, long)
- BigInteger
- char[]配列
BigDecimalの計算方法
BigDecimalでは、Javaの通常の演算子(+, -, *, /)を使用することができません。
BigDecimalはオブジェクト型であり、Javaの演算子は基本的にプリミティブ型(int, float, doubleなど)のみに使用できるからです。
加算(add)
BigDecimal num1 = new BigDecimal("0.1");
BigDecimal num2 = new BigDecimal("0.2");

BigDecimal result = num1.add(num2); // 0.1 + 0.2
System.out.println(result); // 出力: 0.3
減算(subtract)
BigDecimal num1 = new BigDecimal("0.3");
BigDecimal num2 = new BigDecimal("0.1");

BigDecimal result = num1.subtract(num2); // 0.3 - 0.1
System.out.println(result); // 出力: 0.2
乗算(multiply)
BigDecimal num1 = new BigDecimal("0.2");
BigDecimal num2 = new BigDecimal("0.3");

BigDecimal result = num1.multiply(num2); // 0.2 * 0.3
System.out.println(result); // 出力: 0.06
除算(divide)
BigDecimal num1 = new BigDecimal("1.0");
BigDecimal num2 = new BigDecimal("3.0");

BigDecimal result = num1.divide(num2, RoundingMode.HALF_UP); // 1.0 / 3.0
System.out.println(result); // 出力: 0.333333...
divideメソッドを使用する際には、丸めモード(RoundingMode)を指定することが推奨されます。
丸め処理
数値の小数点以下の桁数はscaleで管理されています。
計算において精度が不足する場合や、除算で無限小数が発生する場合には、RoundingModeを使用して丸め処理を行います。
これにより、計算結果を指定された精度に合わせることができます。
丸め処理(setScale)
import java.math.BigDecimal;
import java.math.RoundingMode;

public class BigDecimalExample {
    public static void main(String[] args) {
        BigDecimal num = new BigDecimal("1.23456");

        // 小数点以下2桁で四社五入
        BigDecimal rounded = num.setScale(2, RoundingMode.HALF_UP);
        System.out.println(rounded); // 出力: 1.23
    }
}
除算時の丸め処理
import java.math.BigDecimal;
import java.math.RoundingMode;

public class BigDecimalExample {
    public static void main(String[] args) {
        BigDecimal num1 = new BigDecimal("1.0");
        BigDecimal num2 = new BigDecimal("3.0");

        // 小数点以下2桁で四社五入
        BigDecimal result = num1.divide(num2, 2, RoundingMode.HALF_UP);
        System.out.println(result); // 出力: 0.33
    }
}
モード(RoundingMode)
丸めのモードは以下になります。
- RoundingMode.UP
- 絶対値が大きくなる方向に丸め
正の数でも負の数でも、端数が0でない限り切り上げ
例: 1.1 -> 2, -1.1 -> -2
- 絶対値が大きくなる方向に丸め
- RoundingMode.DOWN
- 絶対値が小さくなる方向に丸め
正数でも負数でも、端数が0でない限り切り捨て
例: 1.9 -> 1, -1.9 -> -1
- 絶対値が小さくなる方向に丸め
- RoundingMode.CEILING
- 正の無限大方向に丸め
正数では切り上げ、負数では切り捨て
例: 1.1 -> 2, -1.1 -> -1
- 正の無限大方向に丸め
- RoundingMode.FLOOR
- 負の無限大方向に丸め
正数では切り捨て、負数では切り上げ
例: 1.9 -> 1, -1.9 -> -2
- 負の無限大方向に丸め
- RoundingMode.HALF_UP
- 四捨五入のように、端数が0.5以上であれば切り上げ、それ以下なら切り捨て
例: 1.5 -> 2, 1.4 -> 1
- 四捨五入のように、端数が0.5以上であれば切り上げ、それ以下なら切り捨て
- RoundingMode.HALF_DOWN
- 四捨五入に似ていますが、端数が0.5の場合は切り捨て
例: 1.5 -> 1, 1.6 -> 2
- 四捨五入に似ていますが、端数が0.5の場合は切り捨て
- RoundingMode.HALF_EVEN
- いわゆる「銀行家の丸め」方式
端数が0.5の場合、直前の数字が偶数なら切り捨て、奇数なら切り上げ
例: 1.5 -> 2, 2.5 -> 2
- いわゆる「銀行家の丸め」方式
- RoundingMode.UNNECESSARY
- 丸めを行わず、正確な結果を要求
もし丸めが必要な場合は、ArithmeticExceptionがスロー
- 丸めを行わず、正確な結果を要求
比較について
BigDecimalの比較は、compareToメソッド、equalsメソッドを使用します。 これにより、精度の高い数値の比較が可能になります。
compareTo
このメソッドは、BigDecimalオブジェクト同士の大小比較を行います。
オブジェクトを比較し、次のいずれかを返します 。
- 0: 左右のオブジェクトの値が等しい場合
- -1: 左のオブジェクトが小さい場合
- 1: 左のオブジェクトが大きい場合
import java.math.BigDecimal;

public class BigDecimalComparison {
    public static void main(String[] args) {
        BigDecimal num1 = new BigDecimal("10.5");
        BigDecimal num2 = new BigDecimal("10.5");
        BigDecimal num3 = new BigDecimal("11.0");

        System.out.println(num1.compareTo(num2)); // 出力: 0 (等しい)
        System.out.println(num1.compareTo(num3)); // 出力: -1 (小さい)
        System.out.println(num3.compareTo(num1)); // 出力: 1 (大きい)
    }
}
equals
小数点以下の桁数やスケール(指数部)まで等しいかどうかを判断します。
import java.math.BigDecimal;

public class BigDecimalEquality {
    public static void main(String[] args) {
        BigDecimal num1 = new BigDecimal("10.50");
        BigDecimal num2 = new BigDecimal("10.5");

        System.out.println(num1.equals(num2)); // 出力: false (スケールが異なる)
    }
}
まとめ
BigDecimalについて簡単に要約すると
- 少数を含む計算で使用する
- 計算方法がメソッドになる
- 比較方法がメソッドになる
となります。
Javaを使用する上では必ず通る道なので少しでも学びの助けになれば幸いです。
Python標準ライブラリ〜datetime編〜
Python標準ライブラリ〜datetime編〜
Pythonを利用する際には、ライブラリやフレームワークを活用する機会が非常に多いと思います。
使えるものは積極的に使った方が効率的ですよね。
今回は、原点に立ち戻って標準ライブラリの使用方法についておさらいします。
標準ライブラリは多数存在しますが、今回は個人的に使用頻度が高いdatetimeライブラリに焦点を当ててまとめます。
datetimeライブラリとは?
datetimeライブラリは、簡単に説明すると日時型の処理ができるライブラリです。
現在の日付や時間の取得から時差の扱い、日時型や文字列型の変換などが行えるライブラリです。
datetimeの使い方
datetimeのクラス
datetimeには以下のクラスがあります。
- datetime.datetime 日時
- datetime.date 日付
- datetime.time 時間
- datetime.timedelta 時差
用途に応じて使い分ける必要があります。
今回は主にdatetimeクラスとtimedeltaクラスの説明になります。
日時の取得
- 現在日時を取得
現在日時を取得したい場合、now()を使用することで取得可能です。
from datetime import datetime
dt = datetime.now()
この時、取得した日時はdatetime型になります。
現在日時から年月日などを単独で取得したい場合はそれぞれ指定することで取得可能です。
from datetime import datetime
# 年
year = datetime.now().year
# 月
month = datetime.now().month
# 日
day = datetime.now().day
# 時間
hour = datetime.now().hour
# 分
minute = datetime.now().minute
# 秒
second = datetime.now().second
なお、この時取得した各値はすべてint型です。
- 指定した日時のdatetime型作成
決まった日時をdatetime型に変換したい場合はdatetimeクラスのコンストラクタに設定することで datetime型のオブジェクトとして作成可能です。
from datetime import datetime
dt = datetime(2024, 2, 22, 20, 45, 30, 2300)
左から年、月、日、時、分、秒、ミリ秒を設定可能です。
※必須は年月日のみ。他未設定時は0が自動で入力されます。
日時型と文字列型の相互変換
pythonでは、異なる型同士では計算できないため、適切な型に変換する必要があります。
- datetime型→文字列型変換
datetime型を文字列型に変換するためにはstrftime()を用いることで変換可能です。
from datetime import datetime
dt = datetime(2024, 2, 22, 20, 45, 30, 2300)
dt_str = dt.strftime('%Y/%m/%d %H:%M:%S.%f')
strftimeの引数に出力したい文字列のフォーマットを指定できます。
区切り文字をハイフンやスラッシュなど自由に設定ができます。
使用可能な書式コードは以下公式ドキュメント参考
(datetime --- 基本的な日付型および時間型)
https://docs.python.org/ja/3/library/datetime.html#strftime-and-strptime-format-codes
- 文字列→datetime型変換
文字列型をdatetime型に変換するためにはstrptime()を用いることで変換可能です。
from datetime import datetime
dt_str = '2024/2/22 20:55:05'
dt_format = '%Y/%m/%d %H:%M:%S'
dt = datetime.strptime(dt_str, dt_format)
strptimeの第一引数に変換したい文字列を、第二引数にフォーマットを指定できます。
日時型の計算
日時を扱う上で、10分後や1週間後などを求めるケースもあると思います。
また、普段よく目にするのは日本時間だと思いますが、他の国ではもちろん時差があるため、その計算が必要になるケースもあると思います。
その際に使用するクラスがtimedeltaになります。
- 日付の足し算、引き算
timedeltaオブジェクトに計算したい時間を設定することでdatetime型との計算が可能になります。
from datetime import datetime, timedelta
dt = datetime(2024, 2, 22, 20, 45, 30, 2300)

# 1週間後
dt + timedelta(weeks=1)

# 5日後
dt + timedelta(days=5)

# 12時間前
dt - timedelta(hours=12)

# 10分後
dt + timedelta(minutes=10)

# 30秒後
dt + timedelta(seconds=30)
timedeltaオブジェクトでは指定できる引数に限りがあります。
※複雑な操作が必要な場合は可読性が悪くなるため、dateutil.relativedeltaを使用することを推奨します。
- 差分の取得
datetime型同士であれば、そのまま計算することが可能です。
from datetime import datetime, timedelta
dt1 = datetime.now()
dt2 = datetime(2024, 2, 22, 20, 45, 30, 2300)

# 差分
dt = dt1 - dt2
この時、timedeltaオブジェクトで2つの日時の差分が取得できます。
まとめ
以上がdatetimeライブラリでできることのまとめになります。
様々なシステム開発において、日時を扱うことは頻繁にあると思います。
pythonの一番基本的なライブラリですが、ふと忘れてしまうこともあるため誰かの参考になればと思います。
実際にpython使うとなるともっと標準ライブラリもまだまだありますし、使い勝手の良い外部ライブラリも山ほどあります。
標準ライブラリであれば、日本語翻訳もされているので学ぶハードルも低いです。
ぜひpythonを使い機会があれば、参考にしていただければと思います。
次もまた、pythonについて何かしらまとめられたらと思います。
Ansibleの概要①
今回はRed Hat社が提供するAnsibleについて説明します。
本記事ではAnsibleの概要、導入効果、実行方法を説明し、Playbookの記法については別の記事で書こうと思います。
Ansibleの概要
AnsibleはRed Hat社が提供する構成管理・自動化ツールです。
インベントリに記載したターゲットに対してPlaybookに記載した手順を実行することで、インフラ構築、ソフトウェアデプロイ、その他さまざまなITプロセスを自動化します。
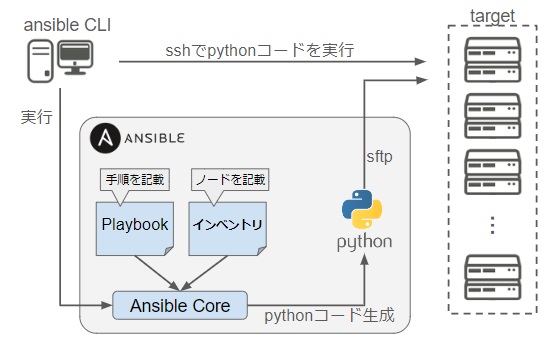
Ansibleの特徴として以下の4点があげられます。
| 特徴 | 説明 |
|---|---|
| エージェントレス | 管理対象へのエージェントのインストールが不要 |
| YAMLによる記法 | YAMLによる可読性の高い簡易な記法、開発言語の取得が不要 |
| 冪等性の担保 | 同じ処理を何回実行しても同一の結果を返す |
| モジュール拡張 | モジュール導入でクラウド、仮想環境、NW機器など管理対象を拡張 |
Ansibleの導入効果
Ansibleの導入効果はいくつかありますが、自動化と冪等性という観点に絞ると以下のようになるかと思います。
- 自動化の効果
自動化により作業時間の短縮が見込めます。
また手作業によるオペレーションミスのリスクを排し、常に同一の品質を担保します。 同一作業を繰り返し実行する場面であるほどこれらは有効です。
Playbookを設計や手順などのドキュメントとして管理する場合は、ドキュメントの標準化やそれに付随したレビュー精度向上が期待できます。
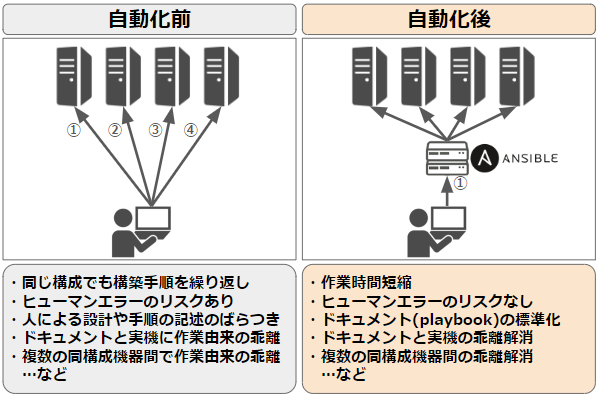
- 冪等性の効果
冪等性により前提の状態によらず実行結果が同じになるため、サーバごとの環境差異を考慮する必要がありません。 また冪等性チェックを実施しており、どの手順でエラーが起きているか(冪等性が担保されないか)をツールで検知します。
IaCツールの比較
Ansible のようにインフラ環境の構築や管理などを記述されたコードにしたがって実行するツールを IaC (Infrastructure as Code) といいます。 IaCツールは様々な種類がでています。今回はその中から Chef、Puppet、Terraform との比較を以下の表にまとめてみました。
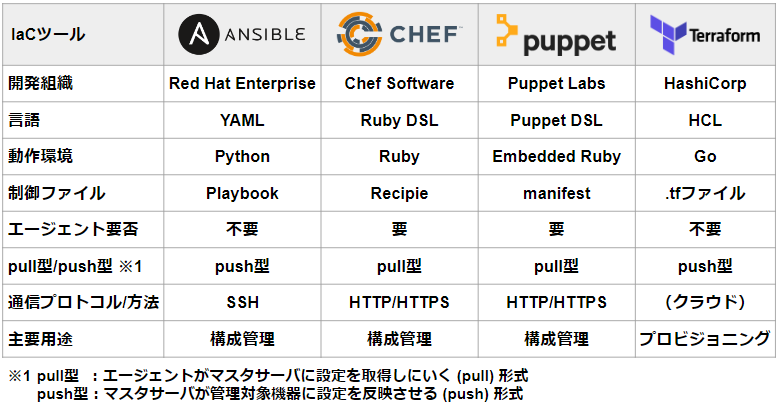
Ansibleのインストールと実行方法
Ansibleはdnfコマンドでインストールできます。
Ansibleをインストールするためにはepel-releaseがインストールされている必要があります。
epel-releaseは各OSの互換性にしたがってインストールしておいてください。
# dnf install -y ansible
Ansibleをインストールすると/etc/ansible/配下にhostsファイルが作成されています。
これがインベントリのファイルであり、ここにターゲットのホスト情報を記述していきます。
インベントリは以下のように[header]のグループごとにホストを記述します。
- /etc/ansible/hosts
[header]
hostnames or ipaddresses
/etc/ansible/にPlaybookをYAML形式で作成します。
$ vi /etc/ansible/playbook.yml
インベントリとPlaybookを記述できたら、以下のコマンドで自動化手順を実行します。
$ ansible-playbook -i hosts -u root -k playbook.yml
最後に
今回はAnsibleの概要、導入効果、実行方法を説明しました。
AnsibleはRed Hat社が提供する構成管理・自動化ツールでインフラ構築、ソフトウェアデプロイなどを自動化することで作業の効率化、品質の担保などの効果が見込めます。
同一作業を繰り返し実行する現場では高い効果を発揮するため使えるようになるといいでしょう。
情報処理安全確保支援士試験の勉強を始める その2
学習スケジュール
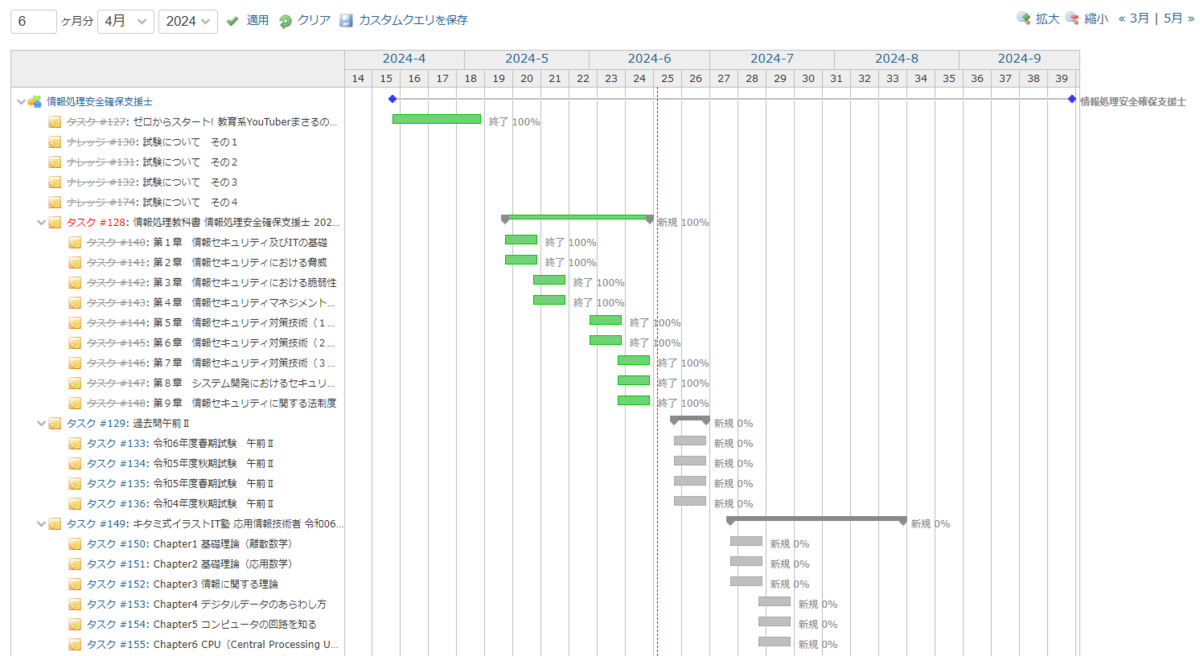
4月から社内のメンバーと共に学習を始め、約2か月半が経過した。
順番としては
・ざっくりどんな事を覚えなければいけないのかを下記書籍で確認。
ゼロからスタート! 教育系YouTuberまさるの情報処理安全確保支援士1冊目の教科書
https://www.amazon.co.jp/dp/4046061979
あまり分厚くなく価格も手ごろで要点を絞ってまとめてくれているのでとっつきやすい。
実際に過去問を解いてみてもそれが実感できるのでおすすめの1冊。
この1冊を読んだ後に午前Ⅱの過去問を解いてみて大体正答率が60%ぐらい。
意外と解ける。
因みに過去問はIPAの公式サイトからも入手可能だが、下記サイトを利用。
解説も付いているのでおすすめ。
ゼロからスタート! 教育系YouTuberまさるの情報処理安全確保支援士1冊目の教科書
www.sc-siken.com
情報処理安全確保支援士試験の勉強を始める その1
情報処理安全確保支援士試験とは
サイバーセキュリティリスクを分析・評価し、組織の事業、サービス及び情報システムの安全を確保するセキュリティエンジニアや、技術・管理の両面から有効な対策を助言・提案して経営層を支援するセキュリティコンサルタントを目指す方に最適です。
情報処理安全確保支援士試験合格者は、情報セキュリティに関する知識・技能を有するものとして、経済産業大臣から合格証書が交付されます。 情報処理安全確保支援士試験合格者は、所定の登録手続きを行うことで、国家資格「情報処理安全確保支援士(登録セキスぺ)」の資格保持者となることができます。 www.ipa.go.jp
試験の実施方式・実施時期
筆記により春期(4月)、秋期(10月)の年2回実施予定
試験時間・出題形式・出題数(解答数)
午前Ⅰ
試験時間:9:30~10:20(50分)
出題形式 :多肢選択式(四肢択一)
出題数:30問
解答数:30問
午前Ⅱ
試験時間:10:50~11:30(40分)
出題形式:多肢選択式(四肢択一)
出題数:25問
解答数:25問
午後
試験時間:12:30~15:00(150分)
出題形式:記述式
出題数:4問
解答数:2問
合格基準
各試験(午前Ⅰ、午前Ⅱ、午後)それぞれで60%以上の正答率
Javaのコレクションフレームワークについて Set編
今回はJavaのコレクションフレームワークの中からSetについて解説します。
Javaのコレクションフレームワークは、データ構造を効率的に扱うための強力なツールセットです。この記事では、Setについて使い方やメリットを解説していきます。
Listについては前回の記事で解説しているのでぜひそちらをご覧ください。
Javaのコレクションフレームワークについて List編
Setについて
Setは重複を許さない要素のコレクションです。順序は保証されません(ただし、LinkedHashSetは例外)。
重複を許さない性質から、データの入れ物としての使い方に加えて、効率の良い複数の要素の重複チェック処理などにも使用されるため、覚えておくと便利なコレクションです。
主な実装クラス
今回はSetからHashSet、TreeSet、LinkedHashSetの3つを紹介します。それぞれの特徴と使い方を見ていきましょう。
HashSet
ハッシュテーブルを使用した高速な実装で、基本的にはこのSetをよく使用します。
◆ 使用場面
- 高速な検索や重複チェックが必要な場合
- 要素の順序が重要でない場合
- 大量のデータを扱う場合
◆ 実装
Set<Integer> numbers = new HashSet<>();
numbers.add(1);
numbers.add(2);
numbers.add(1); // 無視される
System.out.println(numbers.size()); // 2
このように、重複した要素を追加しても追加が行われず、必ず要素が一意に保たれます。
また、このadd()メソッドは追加処理が成功したかをbooleanで返すため重複判定処理にも利用でき、非常に便利です。
List<Integer> inputs = new ArrayList<>(List.of(1,2,1,3,4));
Set<Integer> numbers = new HashSet<>();
for(int input: inputs){
  if(!numbers.add(input)){ // 追加できなかったらfalse
    System.out.println("数値:" + input + " は重複しています");
  }
}
結果:
数値:1 は重複しています
TreeSet
要素を特定の順序で保持する実装です。セットを構築する際に比較基準となるComparatorを渡すことで任意の順序に設定可能です。Comparatorを渡さなかった場合はクラスが持つcompareTo()メソッドを用いて比較を行うことになります(自然順序でのソート)。自作クラスがComparableインターフェースを実装していない場合ClassCastExceptionが発生します。
◆ 使用場面
- 要素を常にソートされた状態で保持したい場合
- 範囲検索やソート順の走査が必要な場合
◆ 実装
Set<String> sortedNames = new TreeSet<>();
sortedNames.add("Charlie");
sortedNames.add("Alice");
sortedNames.add("Bob");
// Alice, Bob, Charlie の順で出力される
// -> Stringはアルファベット順で比較される
for (String name : sortedNames) {
    System.out.println(name);
}
LinkedHashSet
挿入順序を保持するHashSetの実装です。
◆ 使用場面
- 重複を許さず、かつ挿入順序を維持したい場合
◆ 実装
Set<String> linkedHashSet = new LinkedHashSet<>();
linkedHashSet.add("First");
linkedHashSet.add("Second");
linkedHashSet.add("Third");
// First, Second, Third の順で出力される
for (String item : linkedHashSet) {
    System.out.println(item);
}
HashSet、TreeSet、LinkedHashSetの比較
| 特性 | HashSet | TreeSet | LinkedHashSet |
|---|---|---|---|
| 順序 | なし | ソート済み | 挿入順 |
| パフォーマンス(追加/削除/検索) | O(1) | O(log n) | O(1) |
| メモリ使用量 | 中 | 高 | 高 |
| null要素 | 1つ許可 | 不可(※) | 1つ許可 |
※比較処理がnullを許容できない場合
選択基準:
- 高速な操作が必要 → HashSet
- ソートされた要素が必要 → TreeSet
- 挿入順序の維持が必要 → LinkedHashSet
まとめ
今回はJavaのコレクションフレームワークからSetを紹介しました。Setの重複チェックは非常に効率的に実装されているため、for文で実装するより高速に動作します。重複を許さない実装に触れる際はSetの存在を思い出して有効に活用してください。
Javaのコレクションフレームワークについて List編
今回はJavaのコレクションフレームワークの中からListについて解説します。
Javaのコレクションフレームワークは、データ構造を効率的に扱うための強力なツールセットです。この記事では、Listについて使い方やメリットを解説していきます。
Listについて
Listは順序付けられた要素のコレクションを表します。同じ要素を複数回格納することができ、インデックスを使用して要素にアクセスできます。
他に複数の要素を格納する代表的な仕組みとして配列が存在しますが、配列とは異なりサイズが固定されず可変長の入れ物として扱うことが出来ます。また、多くの便利なメソッドを持つため、要素へのアクセス以外の処理を簡単に組むことが出来ます。
主な実装クラス
ListにはArrayListとLinkedList2種類あり、それぞれを用途毎に使い分けることが重要です。それぞれ解説します。
ArrayList
一般的に非常によく使われる動的配列の実装で、各要素へのランダムアクセスが高速です。
◆ 使用場面
- 頻繁に要素の読み取りが行われる場合
- リストの中身があまり変更されない場合
- インデックスを使用してアクセスしたい場合
◆ 実装
List<String> fruits = new ArrayList<>();
fruits.add("りんご");
fruits.add("バナナ");
System.out.println(fruits.get(1)); // バナナ
LinkedList
先頭・末尾への挿入処理が高速な動的配列の実装です。それぞれの要素が次の要素へのリンクを保持することで配列を構成しているためLinkedという名称になっています。
◆ 使用場面
- 頻繁に要素の追加・削除が行われる場合
- イテレータを使用して順次処理したい場合
◆ 実装
List<String> tasks = new LinkedList<>();
tasks.addFirst("緊急タスク");
tasks.addLast("定期タスク");
ArrayListとLinkedListの比較
それぞれの特性から2つを比較して選択する場合の基準はこのようになります。
選択基準:
- データへのランダムアクセスが多い →
ArrayList - 頻繁な挿入/削除操作(特にリストの端) →
LinkedList - メモリ効率が重要 →
ArrayList
と理論上は考えられますが、実際に処理を回してみると先頭への追加削除以外はArrayListの速度が上回っていることが多く、殆どの場合はArrayListを選択して良いと思われます。
まとめ
今回はJavaのコレクションフレームワークからListを紹介しました。ArrayListは特によく登場するクラスであるため、その特性を理解した上で適切に扱えるようになりましょう。
